Mi is az a bináris keresőfa?
Bináris keresőfában olyan értékeket tudunk tárolni, amelyek között értelmezett a kisebbség vizsgálat. A bináris keresőfa ún. node-okból áll. Minden egyes node egy értéket tárol el, valamint két pointer-t, amik az adott node bal- és jobb gyerekét hivatkozzák. Minden node-ra teljesül, hogy a bal gyerekében és annak összes leszármazottjában tárolt érték kisebb, mint a node-ban tárolt érték. A jobb gyerekekre és azok leszármazottjaira pedig a nagyobbság teljesül. Egy bináris keresőfának, ha ismerjük a gyökér elemét, akkor onnan kiindulva már az összes elem elérhető.
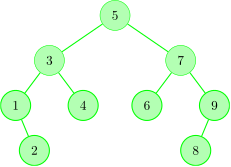
A következő ábrán egy bináris keresőfa látható, amely teljesíti a mefogalmazott elvárásokat.
Miért hasznos a bináris keresőfa?
Ideális esetben a bináris keresőfában gyorsan lehet elemet keresni és új elemet beszúrni. Például, ha el akarjuk dönteni, hogy a fenti fában benne van-e a 6, akkor a gyökérből elindulva tudjuk, hogy a jobb oldali részfát kell használni, onnan pedig a bal oldali fába továbblépve már meg is találjuk a keresett elemet. Könnyen belátható, hogy a fenti fában bármely bent lévő elem legfeljebb négy vizsgálattal megtalálható.
Hogyan implementálható bináris keresőfa C++-ban?
A bináris keresőfa reprezentálásához két dologra van szükségünk.
- Kell egy
Nodestruktúra, amiben tárolható egy node értéke és a két gyermeke. - Tudnunk kell, hogy melyik node a fa gyökere.
Mivel nem tudjuk, hogy milyen típusú értékeket akarunk a fában eltárolni, ezért template osztályt érdemes létrehozni. A Node-ról a külvilágnak nem kell tudnia, ezért ezt a típust érdemes a BinarySearchTree osztályban priváttá tenni.
| |
Az osztály paramétermentes konstruktorát default működéssel megtartjuk, ami esetünkben azt jeleni, hogy a root pointer nullptr-ként lesz inicializálva.
Üres-e a bináris keresőfa?
Érdemes olyan metódust implementálni az osztályban, ami megmondja, hogy üres-e az aktuális bináris keresőfa. Ez egyszerűen megvalósítható, hiszen csak azt kell megvizsgálni, hogy a root pointer mutat-e valamilyen memóriacímre.
| |
Új elem beszúrása
Új elem beszúrása a következő módon valósítható meg:
- Ha a gyökérben nincs még semmi, akkor oda beszúrjuk az új elemet
- Ha a gyökérben van már valami és a beszúrandó elem annál kisebb, akkor a bal oldali részfába kell beszúrni az új elemet
- Ha a gyökérben van már valami és a beszúrandó elem nagyobb annál, akkor pedig a jobb oldali részfába kell beszúrni az új elemet
- Ha a beszúrandó elem megegyezik a gyökérben tárolt elemmel, akkor nem kívánjuk újra beszúrni
Mindez persze nem csak a gyökérre igaz, hanem minden egyes node-ra, ahol éppen tartunk a beszúrási folyamatban. Ez azt jelenti, hogy kiindulunk a gyökérből. Ha kell, akkor onnan továbblépünk a bal- vagy jobboldali részfába, és ott ugyanazt csináljuk, mint amit a gyökérben is tettünk. A tényleges beszúrást pedig akkor fogjuk végrehajtani, amikor egy node-nak olyan gyerekéhez érkezünk, ami valójában még nem létezik. Ott kell létrejönnie az új elemnek.
A létrehozott új elemet viszont be is kell linkelnünk a fába. Ezzel az a probléma, hogy a fa bejárása során amikor eljutunk arra a helyre, ahova az új elemet be kell illesztenünk, akkor már nem fogjuk ismerni, hogy melyik elemből léptünk oda. A probléma megoldására érdemes olyan rekurzív megvalósítást választanunk, ami a függvény hívásokon, illetve a függvény visszatérési értékeken keresztül automatikusan aktualizálja a linkelést.
A konkrét rekurzív implementációban lekezeljük mind a négy esetet.
- Ha az aktuális node még nem létezik, akkor létrehozunk a heap-en egy új
Nodetípusú elemet, amiben a beszúrandó értéket tároljuk el. Ennek az új node-nak a memória címét adjuk vissza eredményül. - Ha a beszúrandó elemet megtaláljuk a fában, akkor eldobunk egy kivételt, ezzel jelezzük, hogy nem történt tényleges beszúrás.
- Ha a beszúrandó elem kisebb, mint az aktuális node-ban tárolt érték, akkor a baloldali részfába szúrunk be, és a beszúrás eredményével felülírjuk a baoldali részfát hivatkozó pointert. Ennek akkor van igazán jelentősége, ha
node->leftkorábbi értékenullptrvolt. - Ha a beszúrandó elem nagyobb, mint az aktuális node-ban tárolt érték, akkor hasonlóan járunk el a jobboldali részfát használva.
| |
Fontos, hogy ezt a rekurzív függvényt nem tehetjük ki az osztály publikus interfészére, mivel a Node típust private-ként definiáltuk. Ezért kell készítenünk egy publikus Insert metódust is, ami paraméterként csak a bemeneti értéket kapja meg. Ez a metódus meghívja majd a rekurzív metódust a root-ból indítva a bejárást. A publikus metódus arról is adhat információt a külvilág felé, hogy sikerült-e beszúrni az új elemet.
| |
Bináris keresőfa felszabadítása
Új elem beszúrásánál a heap-en tároljuk el az új elemet, tehát a bináris keresőfa minden egyes node-ja a heap-en van. Emiatt a fa megszűnésekor az összes node memóriahelyének felszabadításáról is gondoskodnunk kell, tehát felül kell definiálnunk a fa default destruktorát.
A fát felszámolni csak a root-ból kiindulva tudjuk, hiszen direkt módon csak ezt az adatot tároljuk el. A felszabadítás logikája nagyon egyszerű:
- Először számoljuk fel a bal oldali részfát
- Ezután számoljuk fel a jobb oldali részfát
- Végül szüntessük meg az aktuális node-ot
Érdemes ennek érdekében készíteni egy private Dispose(Node*) függvényt.
| |
A destruktor ezt a függvényt fogja meghívni a root-tal, így az egész fa felszabadul.
| |
Move konstruktor és értékadó operátor
Ha felülírjuk a destruktort, akkor a Rule of five értelmében a copy- és move konstruktorok, illetve értékadó operátorok működése is átgondolandó. Első körben csak a move esetével foglalkozunk, mert a copy implementációjához szükségünk lesz majd a fa megfelelő bejárási módjára is.
A move konstruktor implementációja viszonylag egyszerű. Az újonnan létrejövő fában akarjuk eltárolni az eredeti fában lévő összes adatot, mégpedig pont abban a struktúrában, ahogy az eredeti fában voltak. Emiatt csak annyit kell tenni, hogy az új fa root-ja hivatkozzon arra az elemre, ahova az eredeti fa root-ja hivatkozott, az eredeti fa root-ja pedig “felejtse el” a fát.
A move értékadó operátornak is hasonlót kell tennie, viszont ha a felülírandó fában voltak elemek, akkor azokat először fel kell számolni.
| |
Tartalmazás vizsgálat
Annak vizsgálata, hogy elem benne van-e a bináris keresőfában nagyon egyszerű. Kiindulunk a root-ból. Ha itt megtaláljuk a keresett elemet, akkor már kész is vagyunk. Ha nem találjuk meg, akkor attól függően, hogy a keresett elem milyen a root-ban tárolt elemhez képest, vagy a bal- vagy a jobb oldali részfába lépünk tovább. Majd ezt folytatjuk addig, amíg nem találjuk meg a keresett elemet, vagy nem jutunk nullptr linkeléshez. Utóbbi esetben kijelenthetjük, hogy a keresett elem nincs benn a fában.
| |
Legkisebb és legnagyobb elem keresése
Könnyen belátható, hogy a fa legkisebb eleme a legbaloldalibb elem, amit úgy találhatunk meg, hogy a gyökérből addig lépkedünk lefelé, amíg létezik az aktuális node-nak bal gyereke.
Hasonló módon a fa legnagyobb eleme a legjobboldalibb elem.
Fontos megemlíteni, hogy nem minden bináris kereső fának van minimuma és maximuma, hiszen ha üres a fa, akkor egyetlen elem sincs benne. Emiatt az implementációnál érdemes olyan metódusokat definiálni, amik std::optinal<T> típussal térnek vissza.
| |
Bináris keresőfa bejárása
Ha végig akarunk menni egy fa összes elemén, akkor ezt többféle módon is megtehetjük, hiszen nem definiált, hogy mi egy elem rákövetkező eleme. Emiatt tipikusan három különböző bejárási módot szoktunk definiálni:
- Preorder bejárás: feldolgozza az aktuális node-ot, majd továbblép a baloldali részfába, aminek minden elemét preorder módon bejár, utána pedig a jobboldali részfát járja be
- Inorder bejárás: először bejárja a baloldali részfát, majd feldolgozza az aktuális node-ot, ezt követően jön a jobboldali részfa bejárása
- Postorder bejárás: a baloldali részfa bejárásával kezd, majd bejárja a jobboldali részfát, és csak ezt követően dolgozza fel az aktuális node-ot
Abban mindhárom bejárás megegyezik, hogy a baloldali részfát előbb járjuk be, mint a jobboldalit. A bejárást úgy valósítottam meg, hogy enum template paraméterként adható meg a metódusnak, hogy éppen melyik bejárási módot kívánjuk használni.
A metódusnak paraméterként adjuk meg, hogy mit értünk egy elem feldolgozása alatt. Ehhez egy void(const T&) szignatúrájú függvényt kell átadni.
| |
Copy konstruktor és értékadó operátor
Másolat készítésekor azt várjuk el, hogy egy olyan fa jöjjön létre a másolás eredményeként, amely ugyanolyan értékeket és ugyanolyan felépítésben tárol el, mint az eredeti fa. Viszont fontos, hogy minden egyes node-nak tényleges másolata jöjjön létre, ha használja két fa egyszerre ugyanazt a heap területet.
Ezt úgy tudjuk megvalósítani, ha preorder bejárást használunk a másolás során. Átmásoljuk az aktuális node-ban tárolt értéket, majd létrehozzuk a baloldali részfát, illetve a jobboldali részfát.
| |
Fa magasságának meghatározása
Egy bináris keresőfa magassága alatt azt értjük, hogy hány node-nyi a leghosszabb út, ami a gyökérből indul és egy levél elemig tart. (Levélnek a leszármazottal nem rendelkező node-ot tekintjük.)
A fa magassága rekurzív módon könnyen meghatározható:
- A csak levelet tartalmazó részfa magassága 1
- Minden node-ból induló részfa magassága, a node-hoz tartozó bal- és jobboldali részfa magasságának maximuma plusz 1
Ezek alapján a magasság a postorder bejárás logikáját követő módon határozható meg. Ezt most nem úgy implementálom, hogy felhasználom a korábban megírt postorder bejárást, mivel ott a feldolgozó függvény nem a node-ot, hanem a node-ban tárolt értéket kezeli.
| |
Adott értékű elem törlése
A legnehezebb művelet a törlés. Ehhez először meg kell találni a törlendő elemet, amit a tartalmazás vizsgálathoz hasonló módon találhatunk meg. Viszont most rekurzív megoldást adok, mivel a tölés eredményeként a megtalált törlendő elem szülő node-jának is módosulnia kellhet, amit rekurzív megközelítéssel tudunk egyszerűen megírni.
Ha megtaláljuk a törlendő elemet, akkor három különböző esetet kell lekezelnünk:
- Ha a törlendő elemnek nincs baloldali gyermeke, akkor a jobboldali részfáját kell “felemelnünk” a törölt node helyére
- Ha a törlendő elemnek van baloldali gyereke, de nincs jobboldali leszármazottja, akkor a baloldali részfát emeljük a törölt node helyére
- Ha mindkét gyermeke létezik a törlendő elemnek, akkor bonyolult a helyzet. Ilyenkor meg kell találnunk a törlendő elemet követő elemet, amit a jobboldali részfa legbaloldalibb elemeként találjuk meg. Ennek az elemnek az értéket másoljuk be a törlendő node-ba, azaz valójában nem töröljük ki a node-ot, hanem csak a benne tárolt elemet felülírjuk. Ezt követően viszont a bemásolt elem node-ját ki kell törölnünk, amit meg tudunk tenni, hiszen biztosan nincs baloldali gyermeke, mivel akkor nem lehetett volna legbaloldalibb elem egy részfában.
| |
Kapcsolódó bejegyzések
Kapcsolódó kódok
A kódok github-on is elérhetők.